跌倒警报设备
Copyright © Quectel Wireless Solutions Co., Ltd. 2026. All rights reserved.
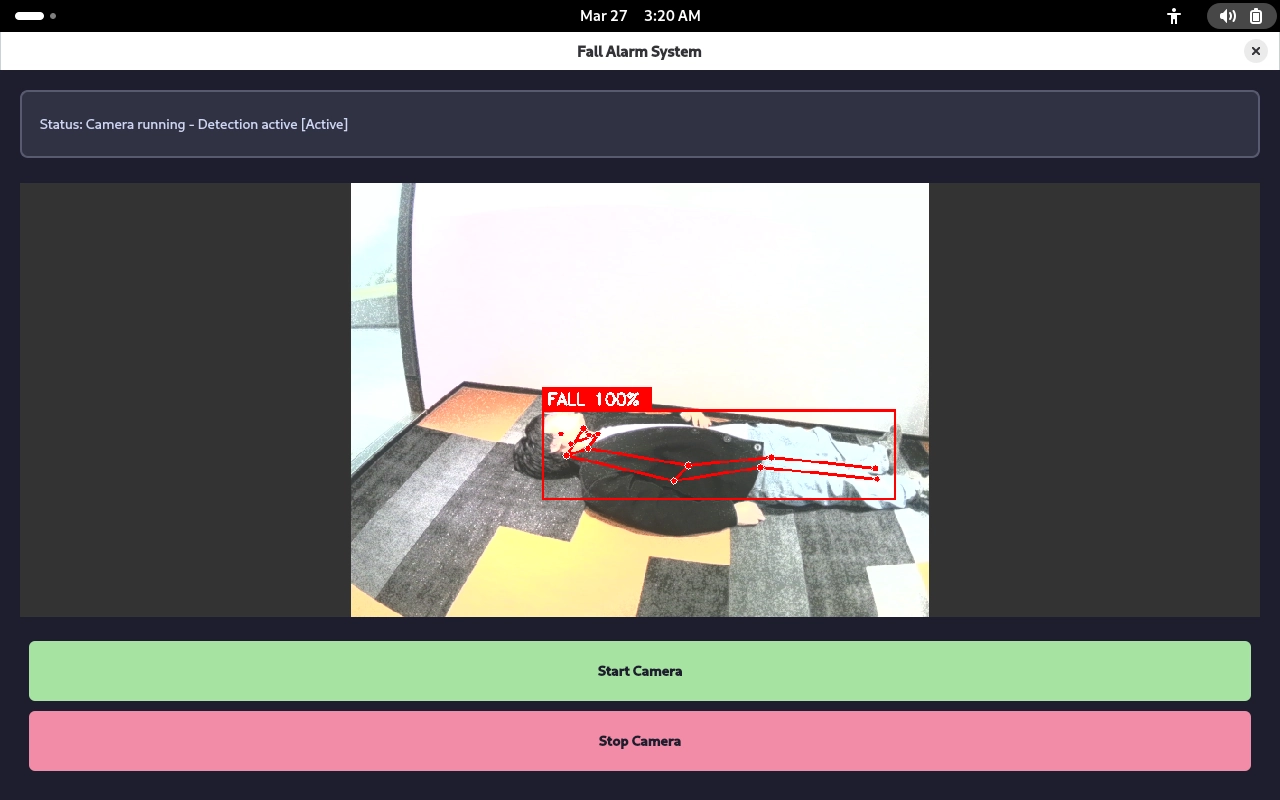
该应用是一个基于 Quectel Pi M2 智能主控板,通过USB摄像头进行实时人体姿态识别,采用YOLOv8-Pose和多人跌倒分类器,自动检测用户是否发生跌倒事件的智能应用。
该项目通过调用摄像头实时采集画面,当检测到跌倒事件时会启动本地报警器并发送通知到手机,用户在手机端通过apk查看跌倒图片,可作为老年人/患者安全监护、跌倒预警系统的参考示例。
开发资源汇总
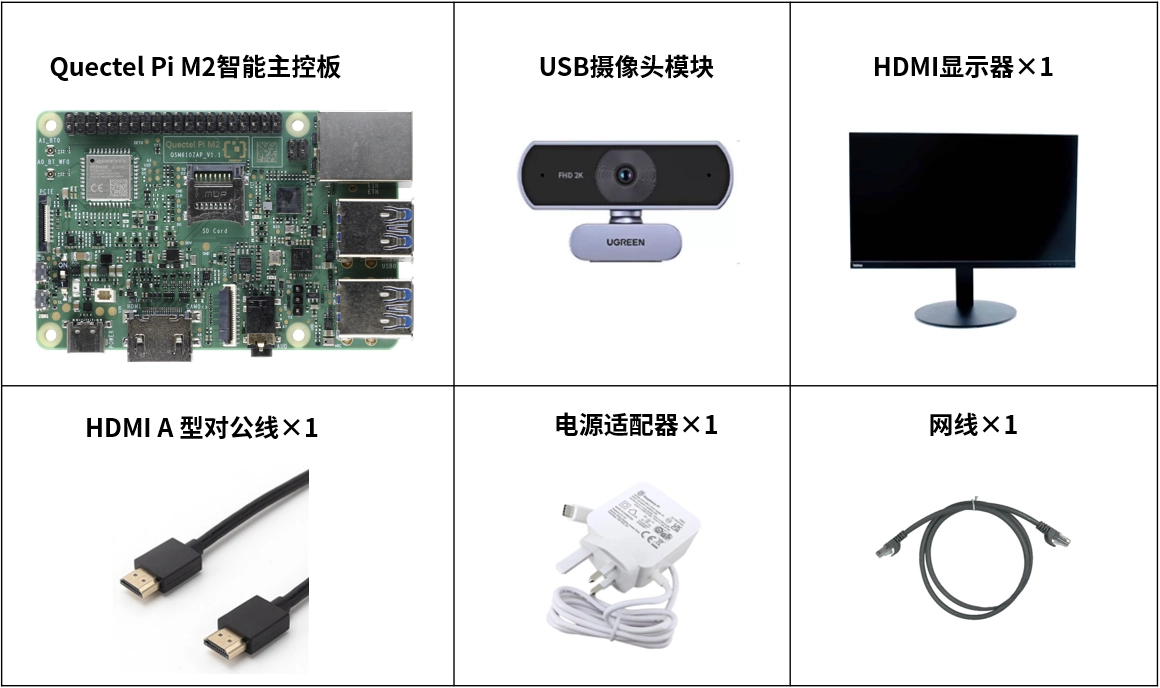
开发配件清单
配件名称 |
数量 |
规格参数 |
|---|---|---|
Quectel Pi M2智能主控板 |
1 |
Quectel Pi M2智能主控板 |
USB摄像头模块 |
1 |
|
USB-C电源适配器 |
1 |
|
CPU散热风扇(可选) |
1 |
|
HDMI A 型对公线 |
1 |
HDMI 2.0;线长1 m;接口:HDMI-A(公头)-HDMI-A(公头) |
网线 |
1 |
线长:1 m;传输速率:千兆 |
显示屏 |
1 |
24英寸HDMI显示器 |
配件实物参考
快速上手
开发准备
Quectel Pi M2智能主控板 出厂预装 Debian 13 系统镜像,因此无需重新烧录系统镜像,按照以下步骤操作即可。
硬件连接
按照以下步骤完成所有硬件连接(步骤编号与接口示意图中的标注一致):
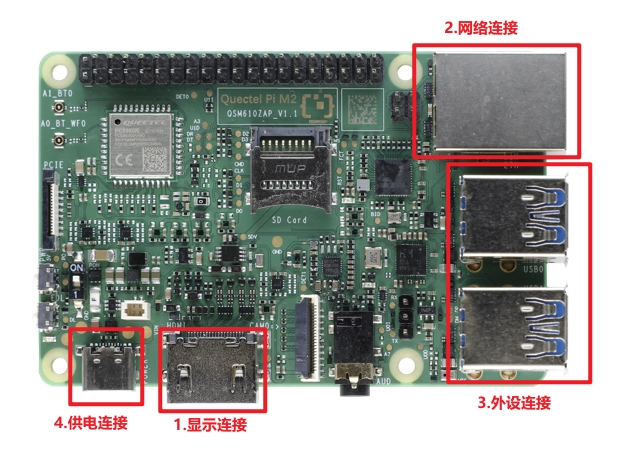
显示连接:将HDMI线的一端连接到智能主控板的HDMI接口,另一端连接到显示器的HDMI接口。
网络连接:确保路由器已连接互联网,然后将网线的一端连接到智能主控板的千兆以太网端口,另一端连接到路由器的以太网端口。
输入设备连接:将USB键盘、鼠标和USB摄像头等输入设备连接到智能主控板的USB接口。如果使用无线输入设备,将无线接收器连接到扩展坞的USB接口即可。
供电连接:将USB-A电源线的USB-A端连接到电源适配器的输出端,将USB-C端连接到智能主控板的电源输入接口(通常标注为 POWER IN)。
项目实现
安装前置
确认有网络连接后,打开终端输入命令:
sudo apt update && sudo apt install -y python3-pip libatlas-base-dev libjasper-dev
上述命令将更新软件源并安装项目运行所需的一些库,具体包括:
libatlas-base-dev 和 libjasper-dev:支持科学计算库的依赖;
python3-pip:Python 包管理器,用于安装项目依赖。
获取代码
代码解压到设备
安装 Python 依赖
pip install -r requirements.txt
依赖包说明:
PySide6:Qt6 的 Python 绑定,用于构建图形用户界面;
opencv-python:OpenCV 图像处理库,用于摄像头采集和图像处理;
ultralytics:YOLOv8 目标检测框架,用于人体关键点检测;
numpy:数值计算库,用于矩阵运算和特征提取;
scikit-learn:机器学习库,用于提供随机森林分类器;
joblib:序列化库,用于加载预训练模型。
准备模型文件
跌倒检测应用需要预加载以下模型文件,请放置在 model/ 目录下:
yolov8n-pose.pt - YOLOv8-Nano Pose 模型,用于检测人体17个关键点
fall_multi_person_model.pkl - 随机森林分类器,用于判断是否跌倒
feature_scaler_multi.pkl - 特征缩放器,用于标准化输入特征
这些模型文件可以从以下方式获取:
yolov8n-pose.pt:从 Ultralytics 官方 GitHub 下载或通过代码自动下载
fall_multi_person_model.pkl 和 feature_scaler_multi.pkl 已放置model目录下
运行应用
完成模型准备后,运行主程序:
cd src
python3 main.py
程序启动后将显示图形界面,提供以下功能:
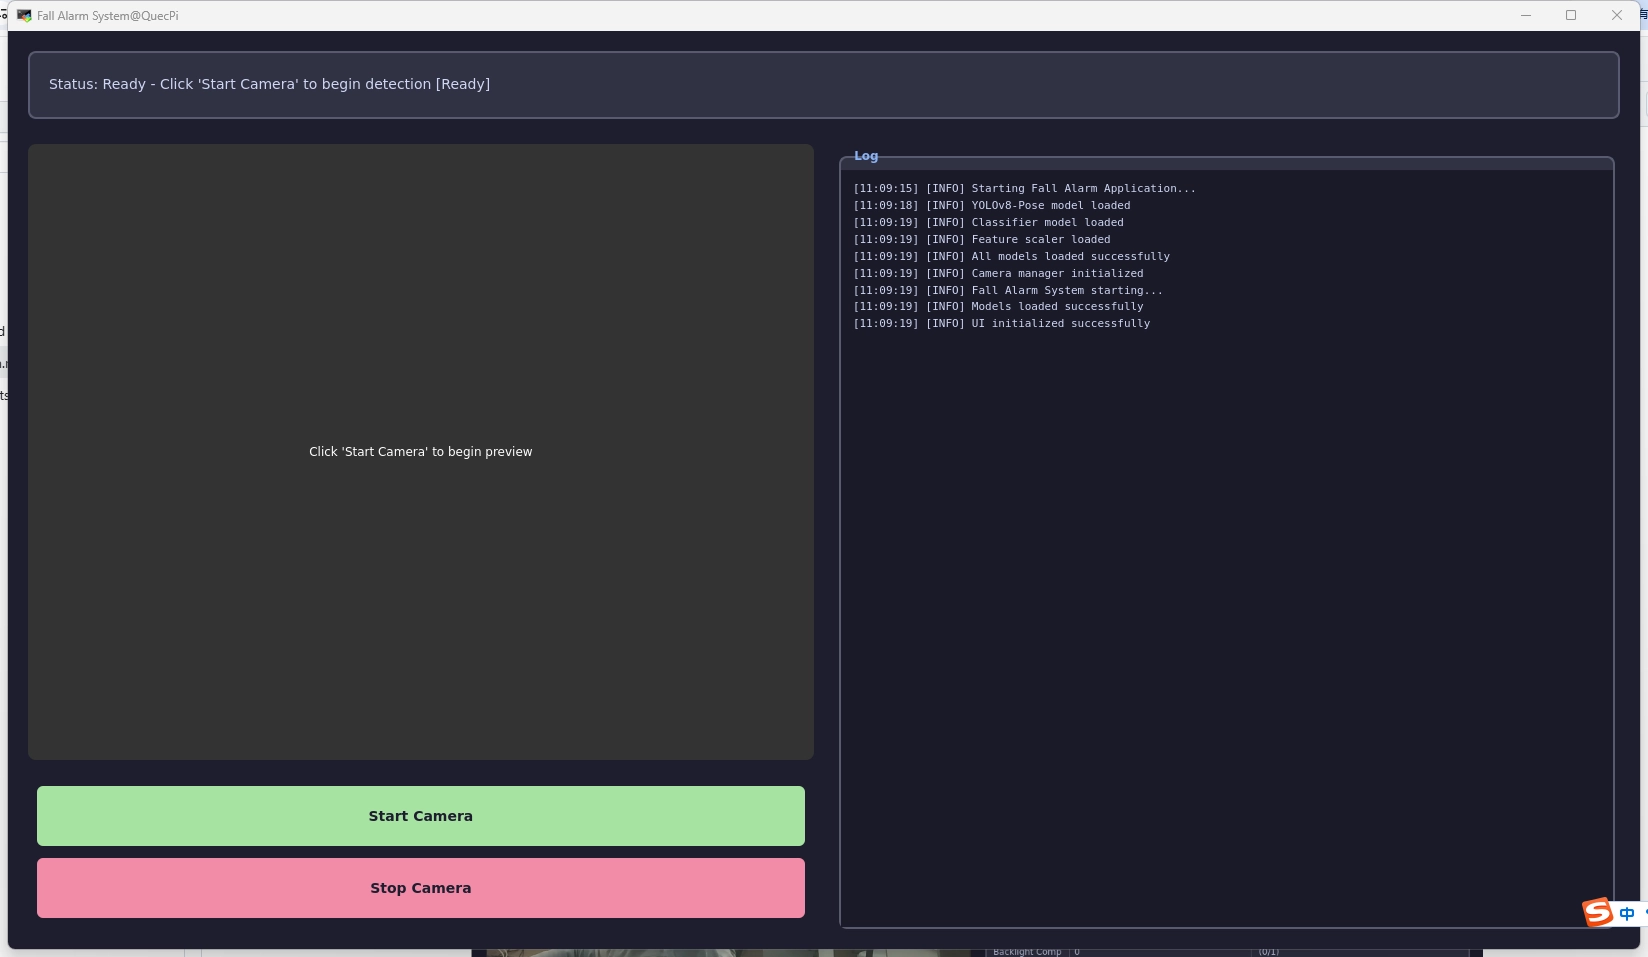
功能界面说明
[电子表格]
日志显示区域
右侧区域可输出应用运行过程中的日志信息,包括:
模型加载日志:显示是否成功加载YOLOv8模型和分类器
检测日志:显示检测到的人体数量和跌倒状态
警报日志:显示跌倒警报和图片上传状态
实时检测参数
程序使用以下参数进行跌倒检测(可根据实际需求调整):
[电子表格]
跌倒检测原理
关键点检测
应用使用YOLOv8-Pose模型检测人体17个关键点:
0: 鼻子       1: 左眼       2: 右眼       3: 左耳       4: 右耳
5: 左肩       6: 右肩       7: 左肘       8: 右肘       9: 左手腕
10: 右手腕    11: 左髋       12: 右髋      13: 左膝      14: 右膝
15: 左脚踝    16: 右脚踝
特征提取
从关键点提取以下特征用于分类:
关键点坐标:17个关键点的(x, y)坐标和置信度,共51维
身体角度:计算8个关键点之间的角度特征,共8维
相对坐标:相对于髋部中心点的相对坐标,共26维
身体形态:身体高度、宽度及高宽比,共3维
跌倒判断逻辑
应用使用多种方法判断是否发生跌倒:
# 特征提取和分类
features = detector.extract_features(keypoints, confidences)if scaler is available:
    features_scaled = scaler.transform(features)else:
    features_scaled = features

# 获取分类器预测
probabilities = classifier.predict_proba(features_scaled)
is_falling = probabilities[0, 1] > FALL_MIN_CONFIDENCE  # 类别1表示跌倒# 确认帧计数(减少误报)if is_falling:
    fall_count += 1if fall_count >= FALL_CONFIRM_FRAMES:
        trigger_alarm()
判断标准:
随机森林分类器概率 > 0.75 且连续3帧检测到跌倒
或者同时满足身体角度 > 55° 且身体高宽比 > 1.2
警报和查看
当检测到跌倒时,应用会:
启动警报灯:通过串口向警报灯设备发送闪光和报警命令
保存报警图片:在
picture/目录保存包含时间戳的JPEG图片上传服务器:将报警图片上传到指定服务器地址
上传地址: (可自行替换服务器地址和上传接口)
支持后台异步上传,不阻断主程序运行
APK端查看:可通过apk端实时接收跌倒通知,并查看报警图片
应用演示
[嵌入内容]
常见问题及解决方案
代码问题修改
设备缺少 pip
Debian 13 默认不预装 pip 与 venv,需要手动安装并配置虚拟环境
adb shell "apt-get install -y python3-pip python3-venv"
int('-camera0') 导致摄像头枚举崩溃
现象:
ValueError: invalid literal for int() with base 10: '-camera0'
这是因为RK3576平台的设备上存在一个符号链接,需要修改代码
def _video_index(path):
    """从 /dev/videoN 提取整数索引,非法名称返回 None"""
    suffix = os.path.basename(path).replace("video", "")
    return int(suffix) if suffix.isdigit() else None# 跳过符号链接(如 /dev/video-camera0 -> video51),只取真实节点
devices = [d for d in glob.glob("/dev/video*") if not os.path.islink(d)]
devices = [(i, d) for i, d in ((_video_index(d), d) for d in devices) if i is not None]
devices.sort(key=lambda x: x[0])
pip 拉取 4GB+ CUDA 版 PyTorch
⚠️ 最容易踩且代价最大的坑。
现象
执行 pip install -r requirements.txt 时,pip 开始拉取一长串 NVIDIA 相关包:
cuda-toolkit==13.0.3
nvidia-cudnn-cu13==9.24.0.43
nvidia-nccl-cu13==2.30.7
nvidia-nvshmem-cu13==3.4.5
nvidia-cublas / cufft / cusolver / cusparse / curand / cufile / cupti
triton~=3.8.0
...
原因
ultralytics 依赖 torch>=1.8.0。PyPI 上的 torch 默认 wheel 是 CUDA 版, 其依赖(通过 cuda-toolkit[...] 元包)在 platform_system == "Linux" 时被无条件拉入。
影响:设备 没有 NVIDIA GPU,这些包:
合计体积 超过 4GB
在 aarch64 上体积巨大,下载 + 解压耗时极长
完全无用(
torch.cuda.is_available()仍为False)
解决
显式指定 PyTorch CPU 索引,先装 torch 再装其余依赖:
# 第 1 步:装 CPU 版(约 159MB,而非 4GB+)
.venv/bin/python -m pip install torch torchvision \
    --index-url https://download.pytorch.org/whl/cpu

# 第 2 步:再装其余依赖(torch 已满足,不会再触发 CUDA)
.venv/bin/python -m pip install -r requirements.txt
验证索引中确有 aarch64 版本
curl -s https://download.pytorch.org/whl/cpu/torch/ \
  | grep -oE 'torch-[0-9.]+%2Bcpu-cp313-cp313-manylinux[0-9_]+_aarch64\.whl' | sort -u | tail -5
实测可用:
torch-2.9.1+cpu-cp313-cp313-manylinux_2_28_aarch64.whl
torch-2.14.0+cpu-cp313-cp313-manylinux_2_28_aarch64.whl   ← 实际安装
torchvision-0.29.0+cpu-cp313-cp313-manylinux_2_28_aarch64.whl
最终结果
torch       : 2.14.0+cpu | CUDA: False
torchvision : 0.29.0+cpu
安装日志中 **无任何nvidia-***包,仅 nvidia-ml-py(ultralytics 的轻量纯 Python 依赖,约 100KB,不影响)。
模型加载相关问题
模型文件找不到
现象:
ERROR - Pose model not found: /path/to/model/yolov8n-pose.pt
ERROR - Classifier model not found: /path/to/model/fall_multi_person_model.pkl
解决方案:
确保
yolov8n-pose.pt、fall_multi_person_model.pkl、feature_scaler_multi.pkl都放在model/目录下检查文件路径是否正确,使用绝对路径测试
第一次运行可以让程序自动下载YOLOv8模型(需要网络连接)
摄像头相关问题
摄像头无法识别
现象:
Warning: No available cameras detected
解决方案:
检查摄像头是否正确连接到USB接口
使用命令检查摄像头是否被识别:
# Linuxls -la /dev/video*

# 使用v4l2-ctl列出摄像头
v4l2-ctl --list-devices
尝试使用其他USB接口
如果还是不行,使用USB集线器并连接电源
检查是否需要安装摄像头驱动程序
摄像头画面卡顿或延迟大
现象:
检测到画面延迟超过1秒,或摄像头预览画面不流畅
原因分析:
摄像头分辨率过高导致处理延迟
CPU占用率过高
网络上传导致主线程阻塞
解决方案:
降低摄像头分辨率(改为1280×720而非更高)
调整
DETECT_INTERVAL参数增加检测间隔:
DETECT_INTERVAL = 0.25 # 从0.15增加到0.25秒
降低
YOLO_IMG_SIZE以加快推理速度:
YOLO_IMG_SIZE = 320 # 可降低到256
禁用服务器上传功能进行本地测试
跌倒检测相关问题
误报率高(误检测正常动作为跌倒)
现象:
用户正在弯腰、坐下或躺着休息时被误检为跌倒
解决方案:
调整分类器置信度阈值:提高阈值可减少误报
FALL_MIN_CONFIDENCE = 0.80 # 从0.75增加到0.80
增加确认帧数:只有连续多帧检测到才判断为跌倒
FALL_CONFIRM_FRAMES = 5 # 从3增加到5
优化角度和比例阈值:
FALL_BODY_ANGLE_THRESHOLD = 65  # 增加角度阈值
FALL_HEIGHT_RATIO_THRESHOLD = 1.4  # 增加高宽比阈值
重新训练分类器:使用更多多样化的训练数据
增加坐下、弯腰等动作的负样本
确保跌倒样本的多样性(不同角度、速度、人物)
增加训练数据集大小
漏检率高(没有检测到实际跌倒)
现象:
实际发生跌倒时没有进行警报
解决方案:
降低分类器置信度阈值:
FALL_MIN_CONFIDENCE = 0.65 # 从0.75降低到0.65
降低确认帧数:
FALL_CONFIRM_FRAMES = 2 # 从3降低到2
检查关键点检测质量:
# 增加关键点需求或降低置信度阈值
MIN_CONFIDENCE = 0.3  # 从0.4降低
MIN_KEYPOINTS = 8     # 从10降低
优化视角:确保摄像头能够看到整个身体
摄像头应该距离用户1-3米
摄像头安装高度应该在1.5-2米
避免侧面或接近垂直的视角
改善光照条件:
保证光线充足,避免阴影和逆光
使用均匀的环境光而非局部强光
警报和上传相关问题
警报灯无法启动
现象:
检测到跌倒但警报灯没有亮起
解决方案:
检查串口连接是否正确
验证警报灯设备是否正常工作
检查
light_control.py中的串口配置:
port = '/dev/ttyUSB0'        # 根据实际设备修改
baudrate = 9600              # 根据设备规格修改
检查串口权限:
sudo chmod 666 /dev/ttyUSB0
根据购买报警灯的文档进行调试,确保发送的命令格式正确
图片上传失败
现象:
ERROR - Upload failed: fall_20240326_143022.jpg
原因分析:
网络连接不稳定
服务器地址错误或服务器不可用
请求超时
解决方案:
检查网络连接:
ping SERVER_IP验证服务器是否运行:
curl服务器地址检查防火墙设置是否允许出站连接
修改服务器地址:
SERVER_IP = "your.server.ip"
性能优化问题
CPU占用率过高
现象:
应用运行时CPU占用率 > 80%,系统响应缓慢
解决方案:
降低检测频率(增加
DETECT_INTERVAL)减小视频分辨率(改为640×480或更低)
禁用实时日志显示或降低日志更新频率
使用 GPU 加速(如果硬件支持)
内存泄漏导致占用率持续上升
现象:
应用运行数小时后内存占用从200MB增长到1GB
解决方案:
检查是否在循环中创建了未释放的对象
定期清空日志缓冲区:
if len(LogManager._logs) > 100:
    LogManager.clear_logs()
确保线程正确关闭
使用内存分析工具检测泄漏:
python3 -m memory_profiler