YOLO模拟推理分割模型
Copyright © Quectel Wireless Solutions Co., Ltd. 2026. All rights reserved.
什么是"模拟推理"与"分割模型"
模拟推理
模拟推理(Simulated Inference) 指不依赖 NPU / VPU 等专用硬件加速器,直接在 CPU 上用通用推理框架(如 ONNX Runtime)完成神经网络的前向计算。
优点:通用性强、无需特定硬件 SDK、部署简单,适合功能验证与算法调试。
缺点:算力利用率不如 NPU,速度较慢(本 Demo 单张约 0.5s)。
适用场景:在真实硬件加速(NPU)方案确定之前,先验证算法与效果。
本 Demo 即采用 CPU 模拟推理:设备端用 ONNX Runtime + OpenCV 直接推理,无需 NPU SDK。
分割模型(实例分割)
目标检测只有"框"(bounding box),而 分割模型 更进一步,输出每个目标的 像素级掩膜(mask),把目标轮廓精确"抠"出来。
任务 |
输出 |
精度 |
|---|---|---|
目标检测(YOLOv8) |
类别 + 矩形框 |
边界是矩形框 |
实例分割(YOLOv8-seg) |
类别 + 矩形框 + 像素掩膜 |
边界贴合目标轮廓 |
yolo11n-seg.onnx 是 YOLO11 的 nano 分割模型,COCO 80 类,约 11.7 MB。
分割效果演示
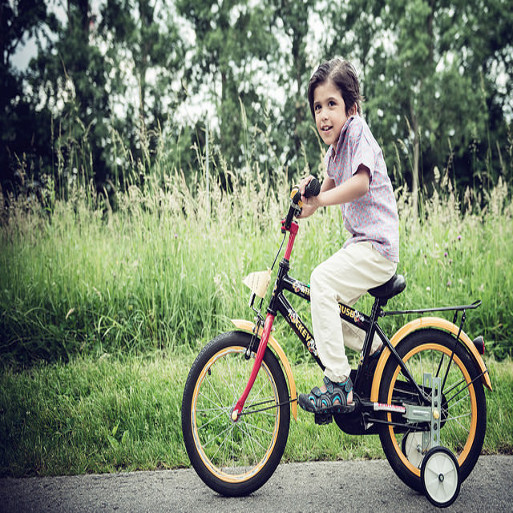
RK3576(Buildroot 系统) 板端分割实测效果(NPU 人像分割 Demo,输入 513x513 原图 → 输出像素级掩膜):
输入原图:
分割结果(人像像素级掩膜):
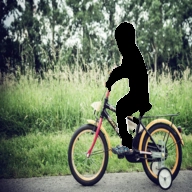
分割模型输出的就是这种"像素级抠图"效果——每个目标一个掩膜,轮廓贴合目标边缘,精度远高于矩形检测框。
分割模型原理简述
YOLO 分割模型(YOLOv8-seg / YOLO11-seg)有 两个输出头:
输出1(检测头): [1, 116, 8400]
                  ├─ 前 4   行:框中心 (cx,cy) 与宽高 (w,h)
                  ├─ 中间 80 行:80 个类别的置信度
                  └─ 后 32  行:每个候选的掩膜系数(mask coefficients)
输出2(原型掩膜):[1, 32, 160, 160]
                  32 张 160×160 的原型掩膜(prototype masks)
掩膜重建公式:
mask = Sigmoid( 掩膜系数(32) × 原型掩膜(32×160×160) ) → 160×160
即用每个目标的 32 个掩膜系数对 32 张原型掩膜做线性组合,再经 Sigmoid 激活与阈值化,得到该目标的二值掩膜,最后缩放到检测框尺寸。
环境准备(M2 / Debian)
安装依赖
# 设备自带 Python 3,安装 OpenCV 与 numpy
sudo apt update && sudo apt install -y python3-opencv python3-numpy

# 安装 onnxruntime(aarch64)
pip3 install onnxruntime
若 pip 安装 onnxruntime 失败,可在宿主机(x86_64)下载 aarch64 wheel 后推送:
adb push onnxruntime.whl /opt/yolo/ && adb shell "cd /opt/yolo && python3 -m zipfile -e onnxruntime.whl /opt/yolo/ort"
部署与文件
目录结构(设备端)
/opt/yolo/
├── yolov8n-seg.onnx      # 分割模型(yolo11n-seg,约 11.7 MB)
├── yolo_seg.py           # 分割 Demo 脚本
├── ort/                  # 兼容版 onnxruntime(CPU 模拟推理用)
└── test.jpg              # 测试图片
模型下载
在可联网宿主机下载后推送:
curl -sL -o yolov8n-seg.onnx \
  https://github.com/ultralytics/assets/releases/download/v8.3.0/yolo11n-seg.onnx
adb push yolov8n-seg.onnx /opt/yolo/
运行 Demo
adb shell "cd /opt/yolo && python3 yolo_seg.py test.jpg"
输出:result.jpg(原图 + 分割掩膜叠加效果),效果见上文"分割效果演示"。
实测性能
项目 |
数值 |
|---|---|
推理方式 |
CPU(ONNX Runtime) |
单张耗时 |
~0.5s |
模型 |
yolo11n-seg (COCO 80 类) |
如需加速,可将分割模型转换为 RKNN 格式走 NPU 推理,参考 [NPU使用指南]。
常见问题
问题 |
解决 |
|---|---|
onnxruntime 安装失败 |
用宿主机下载 aarch64 wheel 推送(见上文) |
ImportError: no module named cv2 |
|
推理慢 |
CPU 模拟推理正常现象;需要速度请转 RKNN 走 NPU |