声源定位
Copyright © Quectel Wireless Solutions Co., Ltd. 2026. All rights reserved.
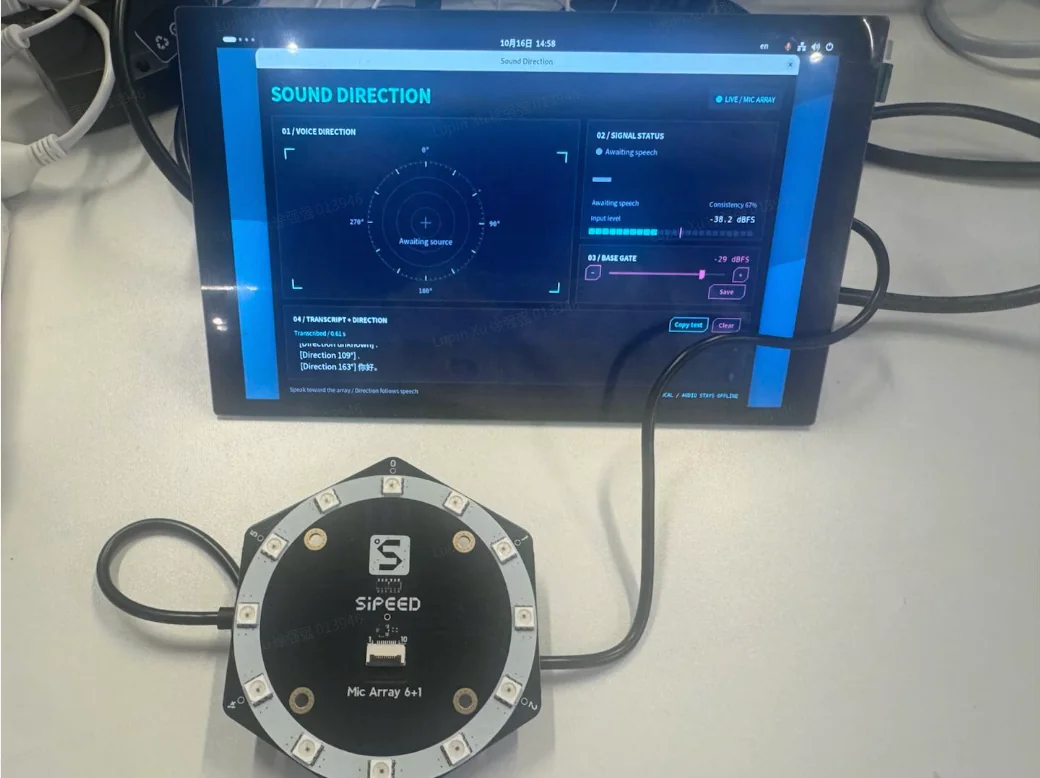
Sound Localization 是一套面向 Quectel PI M2 的本地人声方向与语音转写应用。项目通过 USB 接入 Sipeed 6+1 麦克风阵列和 MA-USB8 驱动板,在 Quectel PI M2 上完成八通道音频采集、人声活动检测、水平面声源定位、SenseVoice 离线语音识别和桌面可视化,适合开发板功能展示、阵列算法验证、边缘语音交互原型和现场调试。
本项目集中展示 Quectel PI M2 对 USB 多通道音频外设、Python/NumPy 信号处理、本地 ONNX 模型推理和桌面图形交互的整合能力。实时音频不会上传,转写结果默认仅保存在进程内存中。
功能概览
通过 ALSA 的
arecord接口采集 48 kHz、16 位、八通道 PCM。使用六路原始麦克风和 GCC-PHAT/SRP 估计水平面声源方向。
在三个分散麦克风上执行 WebRTC VAD 投票,并结合自适应语音频段门限筛选人声。
在后台线程中切分语音,使用本地 SenseVoice INT8 模型进行离线识别。
为每段转写添加
[Direction 060°]形式的方向标签;证据不足时显示[Direction unknown]。支持实时阵列输入、八通道 WAV 回放、合成方向演示、无界面诊断和独立 WAV 转写。
在界面内保留最近 20 段转写,并提供复制、清空和基础门限保存功能。
开发配件清单
以下配件用于完成 Quectel PI M2 上的完整实时演示。无界面诊断不需要显示器和输入设备,合成演示模式不需要麦克风阵列。
配件名称 |
|
规格或要求 |
|---|---|---|
Quectel PI M2 智能开发板 |
1 块 |
作为 USB 音频接入、端侧算法、离线识别和界面显示的主控平台;仓库部署记录对应 aarch64、Debian 13。 |
Sipeed 6+1 麦克风阵列 |
1 个 |
六个外圈原始麦克风需按顺时针顺序映射到 |
MA-USB8 驱动板 |
1 块 |
通过 ALSA 提供 48 kHz、 |
USB 数据线 |
1 根 |
将 MA-USB8 接入 Quectel PI M2 的 USB Host;需要支持稳定的数据传输和供电。 |
显示器 |
1 台,可选 |
直接展示图形界面时使用;SSH 或无屏场景可运行 |
快速上手
环境要求
本项目的主要部署平台是 Quectel PI M2。仓库中的板端部署记录确认了以下环境和外设链路:
Quectel PI M2,aarch64,Debian 13。
Python 3、Tkinter、ALSA 工具和可用的图形桌面会话。
MA-USB8 可被识别为 ALSA 八通道采集设备。
板端已有 NumPy 2.2.4 的部署记录。
Python 依赖声明为
numpy>=1.23,<3、webrtcvad-wheels==2.0.14和sherpa-onnx==1.13.8。SenseVoice INT8 模型及词表;当前模型目录约占 230 MiB。
安装基础依赖
以下命令适用于部署记录中的 Debian 13 环境。它们会安装系统软件包、创建项目虚拟环境、安装 Python 依赖并准备本地模型:
sudo apt install python3 python3-venv python3-numpy python3-tk alsa-utils fonts-noto-cjk
python3 -m venv --system-site-packages .venv
.venv/bin/python -m pip install -r requirements-asr.txt
python3 setup_asr.py
setup_asr.py 需要访问脚本中记录的 GitHub Release 地址。它下载 SenseVoice INT8 模型,检查归档路径后写入:
models/sherpa-onnx-sense-voice-zh-en-ja-ko-yue-int8-2024-07-17/
仓库当前已经包含模型文件时,脚本会直接报告模型可用,不重复下载。
检查音频设备
连接麦克风阵列和 MA-USB8 后,先确认 Quectel PI M2 能发现采集设备:
arecord -l
默认配置期望设备名为 hw:MicArray,0。如果实际名称不同,可以临时覆盖:
bash run.sh --device '<实际 ALSA 设备名>' --probe --seconds 5
也可以修改 [config.json](config.json) 中的 device。
运行板端诊断
在启动界面前执行五秒无界面采集检查:
bash run.sh --probe --seconds 5
成功时,终端会输出一个 JSON 对象,包括设备名、帧数、采集时长、八个通道的 RMS/dBFS、削波计数、人声帧数、有效方向帧数、最后角度、一致性、实际门限和信噪信息。
构建项目
项目没有独立编译步骤,直接在 Quectel PI M2 上运行 Python 源码。虚拟环境和 ONNX 模型均为运行时资产,不是业务代码的构建产物。
启动应用
在 Quectel PI M2 图形桌面的终端中,先进入项目目录。下面的 /path/to 需要替换为实际存放项目的父目录:
cd /path/to/sound_loca_demo
bash run.sh
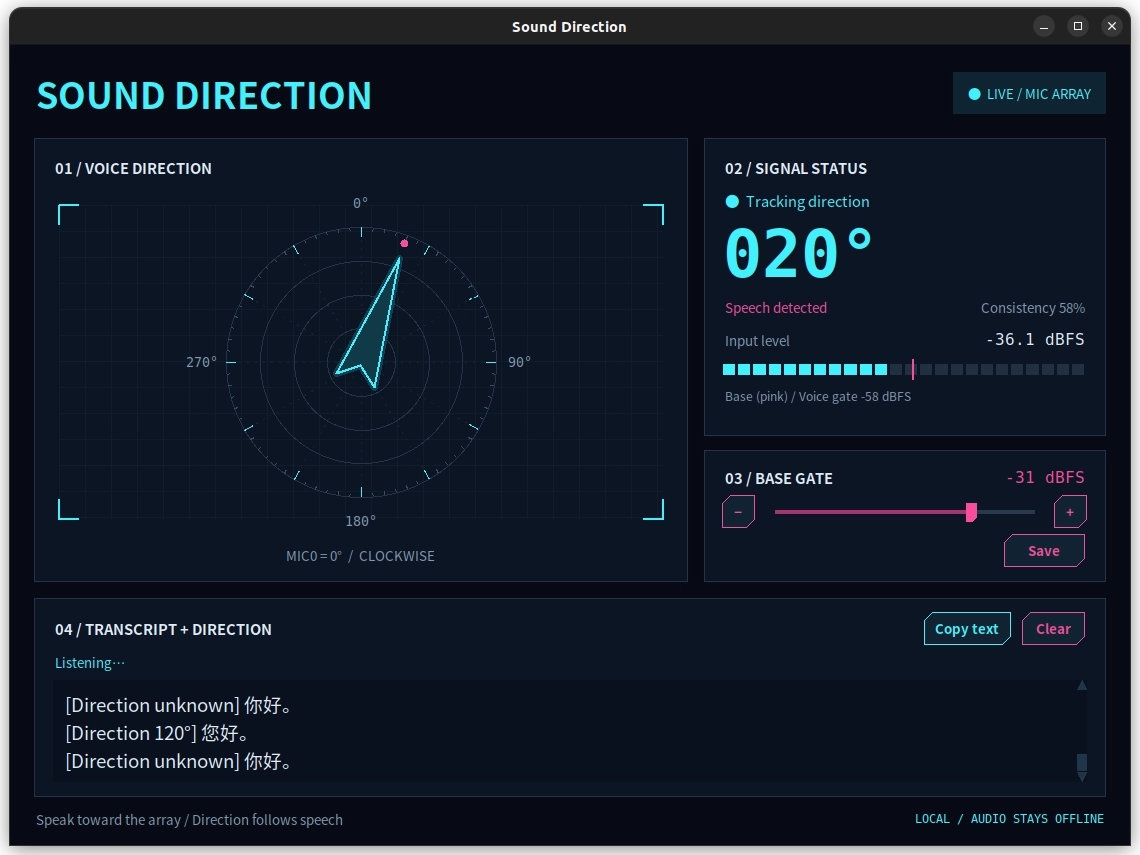
正常启动后,窗口左侧显示方向雷达,右侧显示角度、人声状态、电平和门限,下方显示离线转写。首次运行时先保持环境安静两到三秒,让程序学习稳定的背景噪声频谱。
仅通过 SSH 登录通常不会创建可用的图形桌面会话;这种情况下使用 --probe,或在开发板已登录的桌面终端中启动应用。
应用使用方法
主界面
VOICE DIRECTION:以 MIC0 为 0°,角度顺时针增加。只有人声、方向一致性、语音频段电平和实际门限同时通过时才显示青色箭头。
SIGNAL STATUS:显示当前方向、人声状态、启发式一致性、输入 dBFS、基础门限和自适应语音门限。
BASE GATE:在 -65 至 -20 dBFS 之间调整
gate_dbfs,可使用滑块、方向键或−/+;按钮每次调整 1 dB。TRANSCRIPT + DIRECTION:显示完成的识别结果。Copy text 复制全部当前条目,Clear 从内存中清除条目。
校准并保存基础门限
保持环境安静两到三秒,观察输入电平。
在预期距离以正常音量说话。
将基础门限设置在大部分环境声音之上、正常说话电平之下。数值越负越容易触发。
点击 Save,将
gate_dbfs写回config.json。
基础门限不是唯一的人声判断条件。VAD 确认人声后,程序会依据学习到的稳定噪声频谱计算自适应门限,界面会同时显示基础值和实际使用值。Save 只保存 gate_dbfs,其他配置项需要手动编辑。
查看带方向的转写
确认状态显示模型已经就绪后,面向阵列说完一句,并保持约一秒停顿。转写区会追加类似结果:
[Direction 060°] 你好
[Direction unknown] Direction evidence is insufficient.
方向来自该句话说话期间的有效定位结果,而不是识别完成时的箭头方向。程序按一致性和有效时长进行圆周平均;证据不足或方向冲突时保留文字,并将方向标记为未知。
识别结果最多保留最近 20 段,只存在于当前进程内存。程序不会自动保存实时录音或转写文本。
运行无界面诊断
在 SSH、无屏设备或现场设备排查场景中执行:
bash run.sh --probe --seconds 5
此模式不加载 ASR 模型、不创建窗口,只检查采集、通道电平、人声检测和定位输出。
b@HF-C-S:~/project/sound_loca_demo$ bash run.sh --probe --seconds 5
{
  "device": "hw:MicArray,0",
  "frames": 115,
  "audio_seconds": 4.906666666666666,
  "max_dbfs": -31.141714023559306,
  "channel_rms": [
    0.021183548958751082,
    0.01586236610173023,
    0.014955752892219268,
    0.011623506850791492,
    0.015094008244941195,
    0.01610835825445783,
    0.007044012766777389,
    0.006146897185292454
  ],
  "channel_dbfs": [
    -33.480025583262275,
    -35.99264061744061,
    -36.50383438256843,
    -38.693256481639224,
    -36.42390834231644,
    -35.858974402494034,
    -43.04359731151728,
    -44.226881018967504
  ],
  "channel_clipped_samples": [
    0,
    0,
    0,
    0,
    0,
    0,
    0,
    0
  ],
  "active_frames": 0,
  "last_angle": 330.0,
  "last_confidence": 0.6317844198638005,
  "vad_enabled": true,
  "speech_frames": 7,
  "sentence_direction_frames": 0,
  "effective_gate_dbfs": -58.0,
  "last_snr_db": -1.1870431568712974
}
回放八通道录音
通过与实时输入相同的定位、VAD、分句、识别和界面路径回放 WAV:
bash run.sh --wav recording.wav
文件必须是未压缩的八通道、48 kHz、16 位 PCM。文件中不足一个完整的 2048 样本块时回放结束,界面显示 Playback ended。
运行合成方向演示
没有连接麦克风阵列时,可以用内置合成信号展示 Quectel PI M2 上的方向算法和界面:
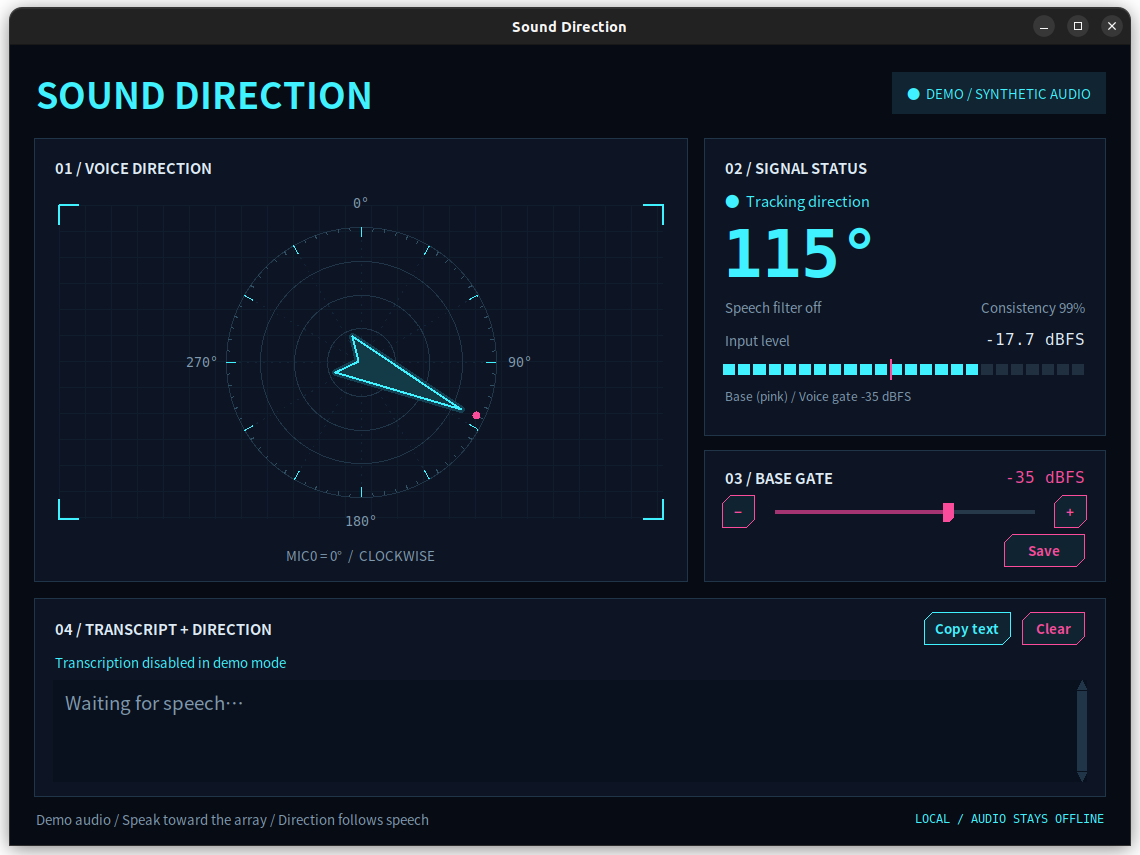
bash run.sh --demo
演示模式会明确显示 DEMO / SYNTHETIC AUDIO,并关闭 VAD 和 ASR。该模式用于界面与方向管线演示,不代表真实场景的声学精度。
独立转写 WAV
短 PCM WAV 可以直接识别:
.venv/bin/python transcribe.py --file recording.wav --channel 0
超过 30 秒的文件需要启用 VAD 分句:
.venv/bin/python transcribe.py --file recording.wav --channel 0 --segment
该工具接受单通道或多通道的未压缩 16 位 PCM,--channel 使用从零开始的索引。自动分句支持 8、16、32 和 48 kHz。识别 JSON 输出到标准输出,不写入文件。单独选择的一个通道不包含阵列几何信息,因此此入口不计算声源方向。
配置
应用启动时读取 [config.json](config.json)。除界面中实时调整的基础门限外,手动修改配置后需要重启。--device 只覆盖当前进程的设备名;应用还会根据实时、演示或诊断模式设置 vad_enabled 和 asr_enabled,因此不应把这两个 JSON 值当成功能切换按钮。
配置键 |
当前值或回退值 |
作用 |
|---|---|---|
|
|
Quectel PI M2 上的 ALSA 采集设备 |
|
|
采样率;MA-USB8 校验要求该值 |
|
|
采集通道数;MA-USB8 校验要求该值 |
|
|
六个互不重复的原始定位通道;拒绝 CH6 |
|
|
外圈麦克风半径,单位为米;有效范围 0.01–0.15 |
|
|
每个定位块的采样数;必须是 512–8192 之间的 2 次幂 |
|
|
基础显示门限;界面范围为 -65 至 -20 dBFS |
|
|
0–1 的启发式方向一致性门限,不代表正确率 |
|
|
对显示和报告方向施加的旋转角 |
|
|
在应用偏移前镜像估计方向 |
|
|
人声结束后保持最后方向的时间 |
|
|
WebRTC VAD 严格度,范围 0–3 |
|
|
三路分散 VAD 通道的起始原始麦克风 |
|
回退值 |
最低语音频段分析电平;当前 JSON 未显式设置 |
|
回退值 |
相对学习噪声的自适应门限裕量;当前 JSON 未显式设置 |
|
|
SenseVoice 语言选择;也可设为 |
|
|
送入语音识别的从零开始通道 |
|
|
CPU 推理线程数;有效范围 1–8 |
|
|
模型和词表目录 |
|
|
人声开始前保留的音频 |
|
|
结束一个语句所需的尾部静音 |
|
|
一个语句所需的最短人声时长 |
|
|
语句自动切段前的最长时长 |
|
回退值 |
一句话所需的最少有效方向时长;当前 JSON 未显式设置 |
|
回退值 |
有效方向对人声时长的最低覆盖率;当前 JSON 未显式设置 |
|
回退值 |
方向圆周集中程度的最低值;当前 JSON 未显式设置 |
无效值会在启动阶段被拒绝。校验覆盖音频格式、通道映射、阵列半径、块大小、方向门限、VAD 设置、ASR 通道与线程数、分句时长和方向汇总阈值。
应用演示
常见问题排查
出现Audio capture timed out 或 Audio device disconnected
检查设备发现情况和占用进程:
arecord -l
fuser /dev/snd/*
确认 MA-USB8 已连接 Quectel PI M2 的 USB Host,并且
device与 ALSA 名称一致。关闭独占采集设备的其他程序,再运行
bash run.sh --probe --seconds 5。若问题仍存在,保留完整错误文本和脱敏后的诊断 JSON。
出现Unable to open window
确认命令运行在 Quectel PI M2 已登录的图形桌面会话中。
仅 SSH 登录时改用
bash run.sh --probe --seconds 5。确认已安装
python3-tk,并检查桌面显示环境是否可用。报告问题时提供 Debian 版本、桌面会话类型、Python 版本和完整错误文本。
出现WebRTC VAD missing 或 Recognition dependency missing
重新创建虚拟环境并安装已声明依赖:
python3 -m venv --system-site-packages .venv
.venv/bin/python -m pip install -r requirements-asr.txt
随后使用 bash run.sh 启动。
出现Speech model missing
检查
asr_model_dir中是否同时存在model.int8.onnx和tokens.txt。执行
python3 setup_asr.py下载模型。确认 Quectel PI M2 能访问脚本中记录的模型下载地址,并有足够存储空间。
保留完整下载或归档错误,但不要公开代理凭据。
方向不稳定、镜像或发生旋转
确认
mic_channels按顺时针列出六个外圈麦克风,且不包含 CH6。测试前保持环境安静两到三秒,让噪声模型完成初始学习。
让一位说话者从已知方向测试,然后调整
angle_offset_deg或mirror并重启。减少其他说话者、播放音频、强反射和阵列附近的稳定噪声。
检测不到人声,或噪声触发箭头
观察输入电平、基础门限、自适应门限和人声状态。
将
gate_dbfs调整到环境电平与正常语音之间,点击 Save。必要时修改
vad_mode、speech_floor_dbfs或speech_snr_db,然后重启。播放的人声也可能触发 VAD,音乐和噪声仍可能造成误判。
识别延迟或有片段被跳过
查看界面是否显示
Transcribing…、识别错误或繁忙提示。ASR 在独立 CPU 线程中运行,队列最多等待两段语音;队列满时会跳过新片段,以保证采集继续运行。
减少其他 CPU 负载,或适当缩短
asr_max_seconds。被跳过的片段不会写入磁盘,也不会自动重试。
文字可以识别,但方向显示为未知
检查说话期间的一致性、语音频段电平和现场反射情况。
确认阵列通道顺序、半径、镜像和角度偏移配置正确。
当前默认至少需要 0.12 秒有效方向、20% 的语音覆盖率和 0.6 的方向集中程度。
不建议仅为消除
unknown而过度降低门限;这可能引入错误方向。
测试与板端验证
从项目根目录运行完整测试:
bash test.sh
测试覆盖合成声源定位、方向平滑与跳变抑制、VAD 分帧和三路投票、自适应门控、语句切分、句内方向汇总、有界 ASR 队列、错误上报和真实模型样例识别。完整测试集包含 35 项;在 Quectel PI M2 正式展示或交付前,应在板端运行全部测试并保留结果。
仓库中的 Quectel PI M2 部署记录确认:基础算法测试曾在板端通过,约五秒实时采集取得 115 帧、4.907 秒音频,八通道均有信号且未检测到削波。该记录证明了板端音频链路可运行,但不构成定位精度或性能指标。
板端部署记录确认定位和人声门控测试曾在 Quectel PI M2 上通过。由于最新版还增加了分句、句内方向汇总和 SenseVoice 识别测试,正式展示前仍需在开发板上重新执行:
bash test.sh
bash run.sh --probe --seconds 5
bash run.sh
并现场检查人声触发、实物方向、转写和长时间运行状态。
已知限制
应用只估计单一主声源的水平面方向,不估计距离或俯仰角,也不分离多个同时说话者。
方向质量受麦克风通道顺序、阵列安装朝向、反射、噪声和现场校准影响。
min_confidence是启发式一致性评分,不是定位正确率。播放的人声可能触发 VAD,音乐或噪声也可能造成误判。
实时录音和转写不会持久化;剪贴板和最近 20 段记录只存在于当前桌面会话。
ASR 队列已有两个任务等待时会跳过新的语句。
USB 音频设备断开后不会自动重连,排除设备问题后需要重启应用。
技术支持与贡献
如在使用过程中遇到问题,欢迎在 移远官方论坛 提交技术咨询,我们的技术支持团队将及时为您解答。